La modélisation de contenu est le travail préalable qui consiste à définir le contenu sous forme de composants réutilisables et interconnectés (types de contenu, champs, relations et règles de validation) avant d’écrire le moindre texte ou de styliser la moindre page. Le modèle de contenu est le plan directeur complet d’un site ou d’une publication ; un type de contenu est un gabarit réutilisable unique au sein de ce modèle, défini par des champs nommés (comme le titre, l’auteur ou la date de publication) et par des règles de validation qui garantissent des données propres. Posez correctement cette structure avant de toucher au design, et la réutilisation, la diffusion via API et la lisibilité par les machines en découlent naturellement.
Voyez le modèle comme la bibliothèque, et chaque type comme une catégorie de livres qu’elle abrite. Un type de contenu Article de blog, par exemple, peut comporter des champs comme title (texte court), slug, author (référence à un type Auteur), body (texte enrichi), category et publishDate, chacun avec ses propres règles.
Cette notion est distincte du design visuel ou d’un gabarit de CMS. Le design détermine l’apparence de cet Article de blog ; le modèle de contenu détermine ce qu’il est, les données qu’il contient et la manière dont il se relie aux autres types. C’est pour réussir cette séparation qu’il est important de comparer la façon dont les plateformes CMS structurent leurs collections avant de choisir vos outils ou vos mises en page.
Les quatre briques fondamentales de la modélisation de contenu sont les types de contenu, les champs, les relations et les règles de validation. Optimizely présente les choses de la même façon dans son guide des briques fondamentales : les propriétés sont les briques des types de contenu, et un type de contenu est un ensemble de propriétés destiné à un usage précis. Dans Contentful, chaque type de contenu est construit à partir de champs que vous définissez vous-même, jusqu’à un plafond documenté décrit dans le modèle de données Contentful, une limite qui impose une modélisation réfléchie plutôt qu’une prolifération sans fin de champs.
Chaque brique a un rôle bien distinct, ce qui apparaît plus clairement lorsqu’on l’applique à un exemple concret :
| Élément | Ce qu’il définit | Exemple dans un modèle Article de blog | Piège courant |
|---|---|---|---|
| Types de contenu | Gabarit réutilisable regroupant des champs liés autour d’un même usage | Article de blog, Auteur, Tag, Métadonnées SEO | Un nouveau type par mise en page au lieu d’un seul type avec des variantes |
| Champs / Attributs | Données typées, avec un type de données et un affichage dans l’éditeur | title : texte court 256 caractères ; slug : texte court ; body : texte enrichi ; publishDate : Date | Du texte long partout, au détriment des limites et du comportement de recherche |
| Relations | Liens entre types ; cardinalité simple ou multiple (tableau) | author : Référence (Auteur vers Articles) ; featuredImage : lien média ; tags : tableau de références | Nom de l’auteur stocké en texte au lieu d’être référencé, ce qui duplique les biographies |
| Règles de validation | Contraintes : obligatoire, unique, format, longueur, références autorisées | title obligatoire ; slug obligatoire + unique + en minuscules ; publishDate et author obligatoires | Aucune règle d’obligation ni d’unicité : des titres vides et des slugs en double finissent en ligne |
Pour un blog marketing, cette structure abstraite devient concrète. Un type de contenu Article de blog contiendrait le titre en texte court, le slug en texte court obligatoire et unique, le corps en texte enrichi, la date de publication en date et heure, l’image à la une en lien média, l’auteur en référence à un type de contenu Auteur, et les tags en tableau de références vers un type de contenu Tag. Contentful définit le texte court (Symbol) avec un maximum de 256 caractères et le texte long avec des limites bien plus élevées, ce qui correspond directement à la façon dont vous contraindriez le titre par rapport au corps dans ce modèle.
C’est la validation qui permet à ce modèle de rester exploitable à grande échelle. Sans contrôle d’obligation sur le slug et le titre, sans unicité du slug, sans validation du format des URL ni limite de longueur sur le titre, les éditeurs créent des chemins en double, des blocs hero vides et des entrées impossibles à analyser, qui cassent à la fois le rendu front-end et la réutilisation en aval.
Les modèles de contenu structurés surpassent les gabarits de page rigides, car ils stockent le contenu sous forme d’éléments modulaires et référençables, réutilisables sur différents supports, diffusables via des API et adaptables à de nouvelles interfaces sans reconstruire les pages. Imaginez la rustine habituelle : une bio d’auteur collée dans trois gabarits, un bloc promotionnel dupliqué pour desktop et mobile, puis une refonte qui casse tout. Le retour sur l’effort de modélisation initial se mesure dans les opérations quotidiennes.
HarperFlow publie des articles très structurés, avec FAQ, tableaux de données et blocs de réponse directe, qui satisfont aux exigences de citation rigoureuses des moteurs de recherche IA. En auditant et en améliorant continuellement votre contenu grâce à l’analyse des réponses IA, HarperFlow aide votre site à bâtir une autorité et une visibilité durables, qui survivent aux stratégies dépendantes de la publicité.
Réutilisation sans copier-coller. Profils d’auteur, descriptifs produits, mentions légales ou CTA n’existent qu’une seule fois, sous forme d’entrées structurées. Pages de destination, hubs de séries et listes d’articles connexes font référence à la même entrée. Mettez à jour la source, et chaque endroit qui y fait référence reflète la modification.
Diffusion omnicanale et via API. Découpler le contenu de sa présentation permet à une même entrée de s’afficher sur un site web, une vue d’application native, un e-mail ou une interface partenaire via API. Vous n’avez plus à maintenir des variantes de page distinctes pour chaque canal.
Pérennité. Quand les frameworks évoluent, que les règles de personnalisation s’étendent ou qu’une interface a besoin d’une carte de réponse rapide, vous remappez des champs au lieu de migrer des pages. Les équipes qui évaluent le fonctionnement réel des différents outils d’IA de création de contenu s’en rendent vite compte : les outils changent, les données sources structurées restent exploitables.
Plus facile à analyser pour les machines. Des champs propres et des relations explicites se transposent directement dans des vocabulaires ouverts. Le vocabulaire Schema.org peut être utilisé avec RDFa, Microdata et JSON-LD et il est conçu pour couvrir les entités et les relations entre entités, ce qui permet aux robots d’exploration, aux analyseurs de données structurées et aux systèmes qui résument le contenu web d’extraire de manière fiable le titre, l’auteur, la date et les entités associées d’un contenu bien modélisé.
Un modèle de contenu est une décision structurelle, pas cosmétique : si vous vous trompez sur les champs et les relations, chaque page en aval et chaque machine qui tente de l’analyser héritent du désordre.
Construire un modèle de contenu pour un blog ou un moteur de contenu consiste à définir une collection Articles de blog comme des données structurées, et non comme une mise en page, avec des champs distincts pour un résumé à réponse directe, le corps du texte, les FAQ, les sources et les relations avec les Auteurs, Catégories et Tags. Le même principe s’applique, que vous modélisiez dans les Collections Webflow ou dans une API headless. Les rédacteurs veulent écrire librement, mais la réutilisation et la lisibilité par les machines reposent sur des champs prévisibles : un compromis qui apparaît clairement dès que vous construisez au niveau de la collection.
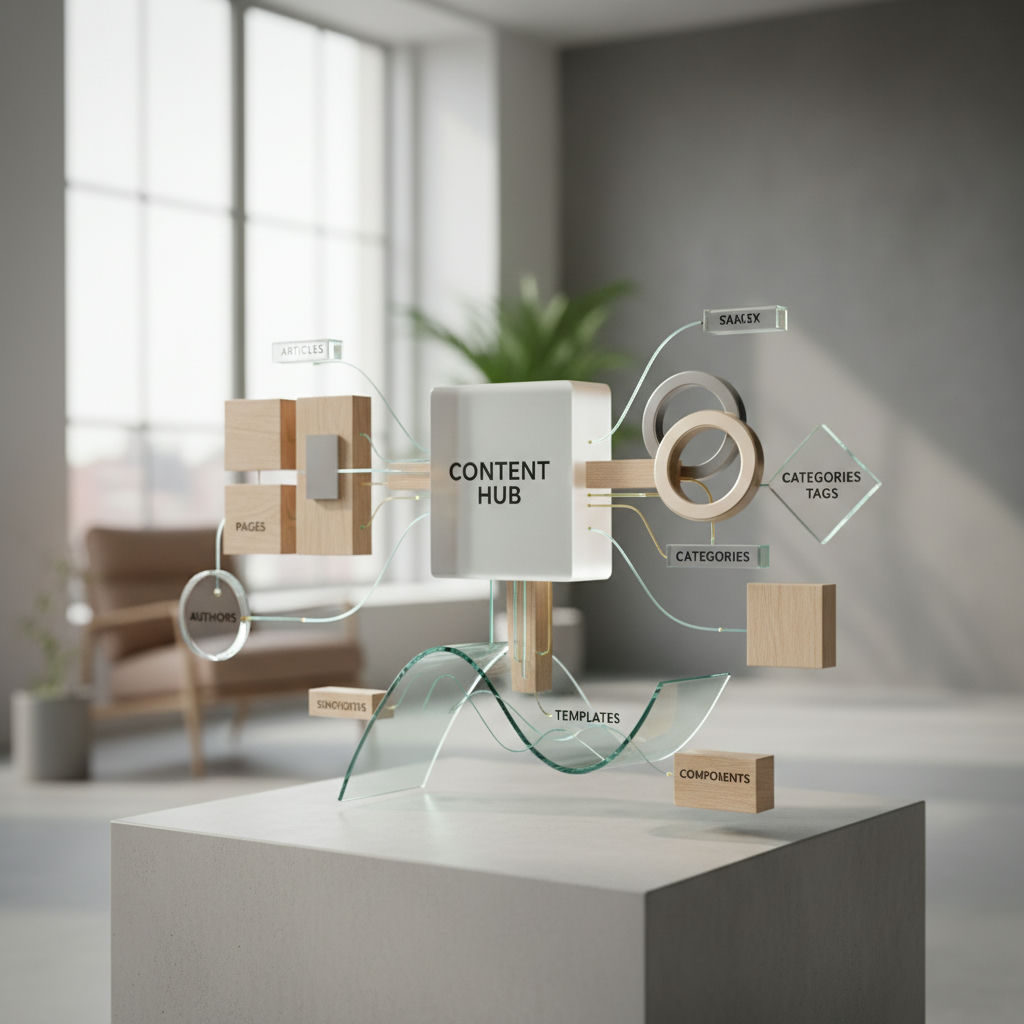
Dans Webflow, vous construisez cela avec les Collections CMS. Une collection Articles de blog contient les champs de l’article, tandis que les Auteurs, Catégories et Tags vivent dans des collections distinctes. Un champ Reference relie un article à un auteur ou à une catégorie ; un champ Multi-Reference vous permet d’associer un élément à plusieurs éléments d’une autre Collection, par exemple pour relier un article à plusieurs tags ou co-auteurs, et se met automatiquement à jour partout où ce tag ou cet auteur est utilisé. Webflow plafonne le nombre de champs de référence autorisés par Collection : les blogs complexes utilisent donc souvent une collection pivot pour contourner cette limite, au lieu de tout aplatir dans des champs texte.
Contentful suit la même logique avec un modèle API-first. Le modèle de contenu d’un espace (space) représente les types de contenu que vous créez, chacun composé de champs, y compris des champs Reference, qui sont des liens vers d’autres entrées, et des champs Array pour les listes de liens. Qu’il soit visuel ou headless, le choix de modélisation est identique : stocker les relations sous forme de références, et non de texte dupliqué.
Un modèle d’article de blog pensé pour les réponses directes gagne à inclure ces champs concrets :
HarperFlow, par exemple, impose automatiquement ce type de modèle structuré lorsqu’il génère et publie des articles sur Webflow : chaque article comporte ainsi les mêmes titres, FAQ, citations et relations, sans qu’un rédacteur ait à contrôler manuellement la cohérence.
Les erreurs de modélisation de contenu cassent discrètement les meilleurs plans directeurs. Un schéma d’échec courant sur des plateformes comme Contentful est le type de contenu fourre-tout : un type unique chargé de champs mal définis, qui rend l’édition pénible et alourdit les réponses de l’API. Voici les six écueils qui érodent un modèle de blog propre au fil du temps.
1. Confondre modélisation et design de page. Les équipes modélisent l’apparence actuelle de la page d’accueil, et non la nature du contenu. Solution : ne modélisez que les données (citation, nom, image) et laissez les choix de mise en page au frontend ou à un conteneur de mise en page distinct.
2. La prolifération des champs. Ajouter un nouveau champ pour chaque cas particulier crée des doublons comme shortDescription, seoDescription et teaserText. Solution : recherchez les chevauchements chaque trimestre et scindez les types volumineux en petits composants réutilisables.
3. Des types incohérents pour un même concept. Trois représentations différentes de l’auteur (l’une en texte brut, l’une en objet imbriqué, l’une en type distinct) empêchent toute réutilisation. Solution : définissez un seul type de contenu Auteur et référencez-le partout via une référence unique.
4. Des relations absentes ou floues. Lorsque les relations sont implicites, les rédacteurs collent des ID ou dupliquent du contenu. Solution : rendez les relations explicites sous forme de références simples ou multiples, et gardez des chaînes peu profondes ; les recommandations de Contentful considèrent trois niveaux de profondeur comme le maximum en pratique avant que les rédacteurs ne perdent le contexte.
5. Repousser la validation jusqu’à ce que les données soient en désordre. Tarder à ajouter des indicateurs obligatoires ou des types autorisés, c’est s’imposer un nettoyage plus tard. Solution : définissez dès le premier jour les champs obligatoires, les limites de caractères et les restrictions de type de référence.
6. Modéliser uniquement pour la page actuelle. Concevoir pour un seul template oblige à tout reconstruire dès que vous avez besoin de vues e-mail, application ou archive. Solution : évaluez chaque type proposé sous l’angle de la réutilisation. Pourrait-il apparaître à plusieurs endroits ou sur plusieurs canaux sans mise en page intégrée ?
C’est en évitant ces erreurs que l’on distingue un modèle de contenu qui tient la route d’un modèle qu’il faudra reconstruire d’ici un an.
Démarrer la modélisation de contenu sans surdimensionner, c’est auditer le contenu existant pour repérer les schémas récurrents et figer la structure avant de passer à l’échelle : une séquence de construction, et non un chantier de nettoyage à mener plus tard.
La modélisation de contenu est un investissement structurel qui rapporte chaque fois que le contenu circule, que ce soit vers un nouveau template, un flux de syndication ou un système qui doit l’analyser. Les équipes qui sautent cette étape gagnent un après-midi aujourd’hui et le paient ensuite en reconstructions à répétition, en copier-coller manuels et en enregistrements incohérents. Verrouillez d’abord le modèle ; la publication s’accélère ensuite.
Contentful autorise jusqu’à 50 champs par type de contenu, comme le précise son modèle de données. Si vous approchez de ce plafond, scindez le type en composants réutilisables au lieu d’ajouter d’autres champs.
Utilisez Symbol pour les titres : Contentful limite Symbol à 256 caractères, ce qui impose des titres concis et faciles à rechercher. Réservez le texte enrichi au corps de l’article, où la longueur et la mise en forme comptent, comme décrit dans le modèle de données.
Faites de l’auteur un type de contenu à part entière et reliez-le par une référence. La bio, la photo et les liens n’existent ainsi qu’à un seul endroit, et modifier l’auteur met à jour chaque article qui y fait référence, sans corrections manuelles par copier-coller.
Un champ Reference relie une seule entrée, comme un article à sa catégorie principale. Un champ Multi-Reference vous permet d’associer un élément à plusieurs éléments d’une autre Collection, ce qui est idéal pour les tags ou les coauteurs.
Gardez des chaînes peu profondes. Un guide consacré à Contentful indique trois niveaux comme maximum en pratique avant que les rédacteurs ne perdent le contexte. Si vous avez besoin d’aller plus loin, créez une collection pivot qui regroupe les contenus au lieu d’imbriquer davantage.
Vous pouvez modéliser correctement avec les deux. Webflow utilise des Collections dotées de champs Reference et Multi-Reference, tandis que Contentful repose sur des espaces : chaque espace possède un modèle de contenu qui représente les types de contenu que vous créez. Le principe consistant à référencer plutôt qu’à dupliquer reste identique.
Modélisez les FAQ comme une collection distincte avec des champs question et answer, puis référencez-les depuis le type Article de blog via un tableau. Les paires question-réponse restent ainsi réutilisables d’un article à l’autre et dans les centres d’aide, et se traduisent proprement en données structurées.
Rendez title et slug obligatoires, imposez un slug unique et en minuscules, et limitez les champs de référence aux types autorisés, comme Auteur ou Tag. Ajoutez des limites de longueur sur les textes courts et des contrôles de format sur les URL pour bloquer dès la création les entrées vides ou en double.