Cet article définit les liens internes en HTML comme des éléments d’ancrage qui pointent vers le même site ou la même page. Il explique les liens vers une section de la même page avec des identifiants de fragment et les liens entre pages avec des chemins relatifs et relatifs à la racine, présente la syntaxe exacte et montre pourquoi un texte d’ancrage descriptif, l’emplacement des liens et une hiérarchie peu profonde influencent le SEO et l’exploration. Il recense les erreurs courantes, comme les id en double et les pages orphelines, clarifie l’usage de l’attribut rel et se termine par une checklist pratique.
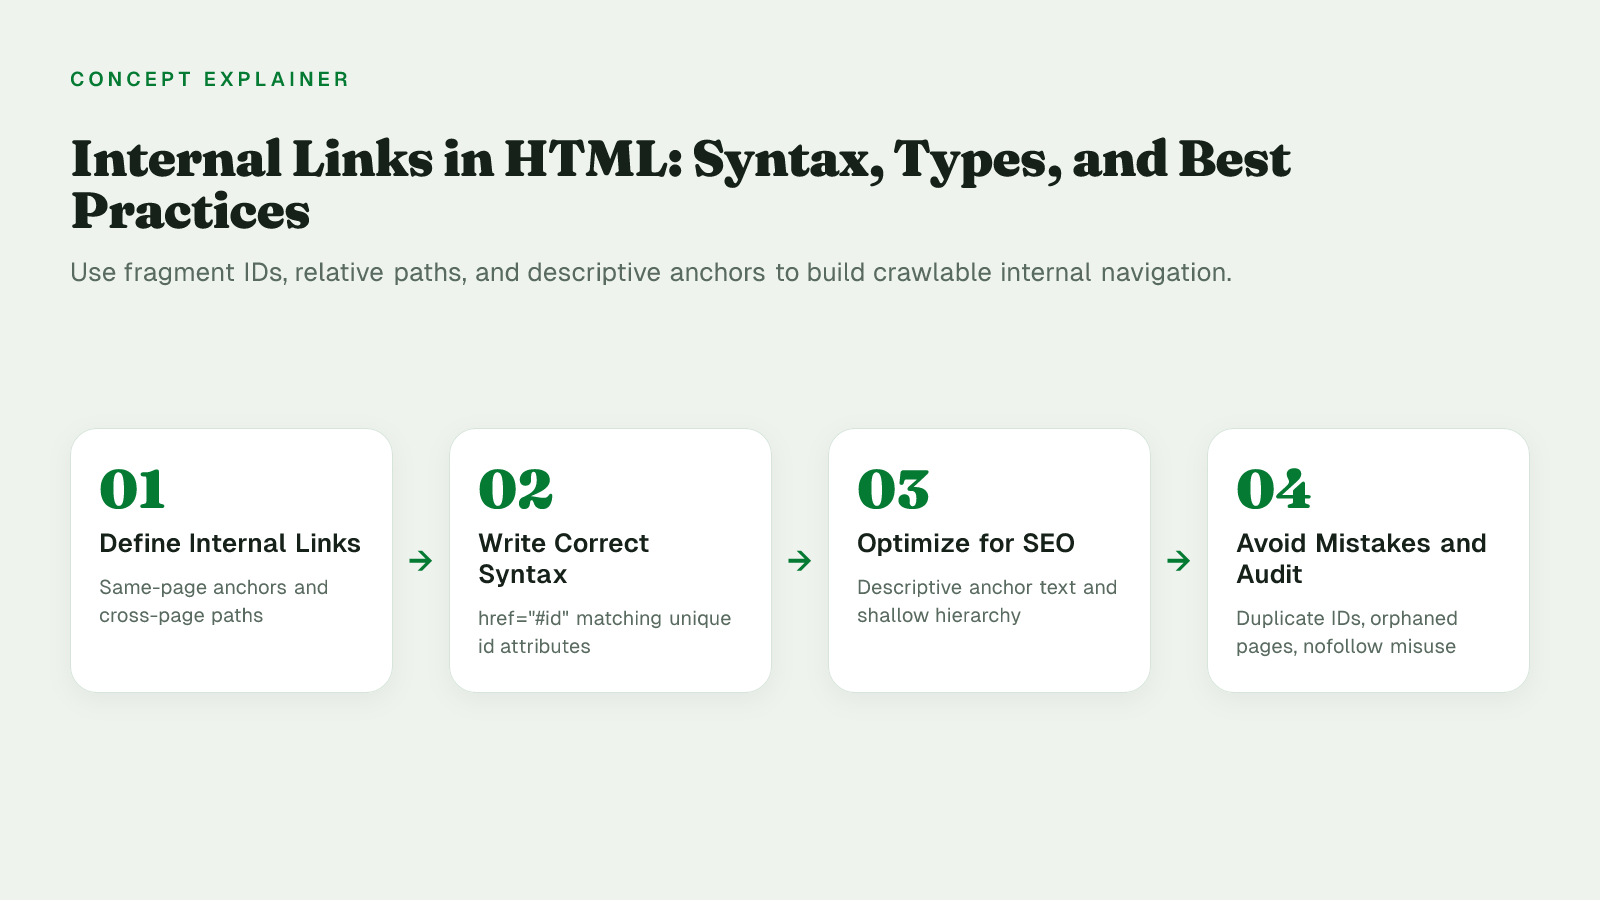
Un lien interne en HTML est un élément <a> dont l’attribut href pointe vers un emplacement du même site ou de la même page, et non vers un domaine externe. HTML distingue deux grands types de navigation interne : les liens d’ancre intra-page, qui renvoient vers un élément précis de la même page, et les liens entre pages, qui utilisent des chemins relatifs ou relatifs à la racine pour atteindre d’autres pages du même site.
Les liens intra-page maintiennent l’utilisateur dans le document en cours, tandis que les liens entre pages relient des documents distincts au sein d’une structure navigable ; tous deux reposent pourtant sur le même modèle d’ancre. L’élément <a> crée un lien hypertexte vers des pages web, des fichiers, des adresses e-mail, des emplacements de la même page ou toute autre ressource accessible par une URL, et un élément cible doté d’un id sert de point d’arrivée à la navigation par fragment. Ce couple href + id en constitue le fondement conceptuel : l’un définit la destination du lien, l’autre l’endroit où il aboutit.
Les liens internes ne nécessitent pas l’élément obsolète <a name>. Un lien interne vers la même page s’écrit <a href="#id"> et cible n’importe quel élément portant cet id, tandis qu’un lien interne vers une autre page utilise un chemin relatif comme about.html ou /folder/page.html pour pointer vers un autre fichier du même site. Voici précisément comment s’écrit chaque type.
Un identifiant de fragment est la dernière partie de l’URI, qui commence par le caractère #. Il n’est pas envoyé au serveur et est traité par le client une fois la ressource récupérée. Dans un document HTML, le navigateur fait défiler la page jusqu’à l’élément dont l’id correspond au fragment.
Syntaxe du lien : href="#value" doit correspondre exactement à id="value" sur la cible. L’id doit être unique dans le document.
<!-- table of contents -->
<nav>
  <a href="#features">Features</a>
  <a href="#pricing">Pricing</a>
</nav>

<!-- targets elsewhere on same page -->
<section id="features">
  <h2>Features</h2>
  <p>...</p>
</section>

<section id="pricing">
  <h2>Pricing</h2>
  <p>...</p>
</section>
Vous pouvez aussi créer un lien vers un fragment situé sur une autre page interne :
<a href="/docs/setup.html#prerequisites">Setup prerequisites</a>
Pour l’élément <a>, l’attribut href contient l’URL vers laquelle pointe le lien hypertexte. Pour les liens au sein d’un même site, les navigateurs résolvent les URL relatives par rapport à l’emplacement du document en cours. MDN présente des exemples de chemins relatifs au schéma, à l’origine, au répertoire courant et au répertoire parent :
about.html ou p — fichier dans le même dossier./p — référence explicite au même dossier/en-US/docs/Web/HTML ou /blog/post.html — relatif à l’origine, depuis la racine du site../p ou ../index.html — relatif au répertoire parent, un niveau au-dessus<a href="about.html">About us</a>
<a href="/blog/post.html">Blog post</a>
<a href="../index.html">Home</a>
<a href="https://example.com/contact.html">Contact (absolute URL)</a>
Les URL absolues incluent le schéma et l’hôte (https://example.com/page.html) et pointent toujours vers cet hôte. Les chemins relatifs rendent les liens internes portables lorsque le domaine change ou lors du passage du staging à la production : c’est donc le choix par défaut pour la navigation interne.
Google utilise les liens comme signal pour déterminer la pertinence des pages et pour découvrir de nouvelles pages à explorer : la formulation, l’emplacement et la profondeur des liens internes déterminent donc directement si vos pages sont découvertes, comprises et mises en avant.
La documentation de Google sur les bonnes pratiques en matière de liens explique que le texte d’ancrage doit être descriptif, raisonnablement concis et pertinent à la fois pour la page actuelle et pour la page de destination. Les libellés génériques comme « cliquez ici » ou « en savoir plus » y sont cités comme de mauvais exemples, car ils ne donnent aucun signal thématique aux utilisateurs ni aux robots d’exploration, alors qu’une expression comme « liste des types de fromages » indique clairement ce que couvre la page liée.
L’emplacement influe sur la force du signal transmis par un lien. Les liens contextuels placés dans le contenu transmettent le contexte de la phrase qui les entoure, ce qui aide Google à interpréter la pertinence de la page cible. Les liens de navigation et de pied de page sont utiles pour s’orienter, mais comme ils se répètent sur de nombreuses pages, ils fournissent un contexte thématique moins précis qu’un lien placé délibérément dans un paragraphe traitant du même sujet.
La hiérarchie et la profondeur déterminent l’explorabilité. Google Search Central indique que chaque page qui compte pour vous doit recevoir un lien depuis au moins une autre page de votre site, et ses premières recommandations sur l’architecture des liens en font une étape clé si vous souhaitez que votre site soit indexé. Des chemins courts, généralement à 2-3 clics de la page d’accueil, et le regroupement des pages connexes en clusters thématiques clairs rendent la découverte plus fiable que de laisser du contenu orphelin au fin fond de sections sans liens.
Les guides SEO du secteur reprennent le même principe : le texte d’ancrage doit refléter le sujet de la page de destination plutôt que de répéter le même mot-clé ou de gonfler le nombre de liens. Un texte d’ancrage descriptif et contextuel favorise davantage la découvrabilité que l’ajout de liens supplémentaires aux libellés vagues — une règle qui guide les attributs et les erreurs courantes abordés ci-dessous.
Les erreurs courantes de maillage interne en HTML sont les chemins relatifs cassés après une restructuration, les attributs id dupliqués ou incohérents qui empêchent les sauts #anchor au sein d’une même page, les pages orphelines sans aucun lien interne entrant, et l’ajout de rel="nofollow" à la navigation interne classique.
Même une syntaxe correcte peut échouer en pratique si vous ne prêtez pas attention à ces points de défaillance. Vous déployez une nouvelle arborescence de dossiers, dupliquez une section de modèle qui utilise déjà id="faq", publiez une page vers laquelle aucune autre page ne pointe, ou recopiez dans votre propre menu un motif rel="nofollow" tiré d’un exemple de lien externe. Chacune de ces situations crée une défaillance silencieuse pour les utilisateurs comme pour les robots d’exploration.
| Erreur | Cause | Solution |
|---|---|---|
| Chemins relatifs cassés après une restructuration | Après un déplacement de fichiers, href="./post.html" pointe encore vers d’anciens chemins |
Utilisez des chemins relatifs à la racine comme /resources/post.html ; lancez un crawl pour vérifier |
Un id dupliqué ou incohérent casse les sauts d’ancre |
Les sections copiées réutilisent id="pricing" ; les id sont sensibles à la casse |
Imposez des id uniques en minuscules ; faites correspondre exactement href="#id" |
| Pages orphelines sans aucun lien interne entrant | Nouvelle page publiée mais jamais liée depuis la navigation ou le contenu | Ajoutez un lien standard <a href> depuis une page hub |
rel="nofollow" appliqué à la navigation interne |
Croire que nofollow économise le budget de crawl | Réservez nofollow aux liens non fiables, sponsorisés et UGC |
C’est souvent dans l’attribut rel que l’intention se perd. Cet attribut définit la relation entre une ressource liée et le document actuel, et MDN définit nofollow comme le signe que l’auteur ne cautionne pas le document référencé. Google Search Central recommande d’utiliser nofollow uniquement lorsque vous ne faites pas confiance à la source, une règle qui vise les liens externes non fiables ou générés par les utilisateurs, et non votre propre navigation. L’appliquer en interne indique aux robots d’exploration de ne pas transmettre de signaux de recommandation à des pages qui vous appartiennent.
Le contenu orphelin est le problème inverse. Si une page n’est accessible que via le sitemap ou des liens de routeur JavaScript, corrigez-le en ajoutant un lien d’ancrage standard depuis les pages hub pertinentes, et vérifiez que le href pointe vers une URI réelle.
Passez ce court contrôle qualité chaque fois que vous ajoutez, déplacez ou renommez des fichiers : il sacrifie un peu de vitesse de publication pour que vos sauts d’ancre et votre navigation restent explorables.
HarperFlow publie des articles très structurés, avec FAQ, tableaux de données et blocs de réponse directe, qui répondent aux exigences de citation rigoureuses des moteurs de recherche IA. En auditant et en améliorant continuellement votre contenu grâce à l’analyse des réponses IA, HarperFlow aide votre site à bâtir une autorité et une visibilité durables, qui survivent aux stratégies dépendantes de la publicité.
id en double qui diviseraient les cibles #fragment. Chaque destination de saut ne doit exister qu’une seule fois sur la page../, ../ et relatifs à la racine /path avant le déploiement.Sur un petit site statique, vous pouvez coder ces vérifications à la main et les revalider avec un build local et un crawler après chaque mise en production. Dès que vous publiez un volume d’articles plus important, la revue manuelle ne suffit plus et un workflow de publication doit appliquer les mêmes règles au moment de publier. HarperFlow est un exemple de workflow de publication Webflow construit autour de ce principe : l’automatisation ne vaut la peine que si elle améliore la qualité, et un maillage interne cohérent, appliqué automatiquement à tous les articles publiés, en est justement un exemple.
Le fragment qui commence par # n’est pas envoyé au serveur et est traité par le client après le chargement de la page. Le navigateur l’utilise pour faire défiler la page jusqu’à l’élément dont l’id correspond au fragment. Vous ne pouvez donc pas vous fier aux logs serveur pour savoir quel fragment a été demandé.
Oui. Utilisez un chemin suivi d’un fragment, comme href="/docs/setup.html#prerequisites", où prerequisites correspond à un id de cette page. Le navigateur charge /docs/setup.html puis fait défiler la page jusqu’à id="prerequisites". Les deux parties doivent être correctes : le fichier doit exister et l’id doit être unique sur la page de destination.
Les valeurs id doivent être uniques au sein d’un document. Si vous dupliquez id="faq", un lien vers href="#faq" peut sauter à la première occurrence ou se comporter de manière incohérente. Pour corriger le problème, recherchez les valeurs id en double dans le fichier et renommez-les avec des valeurs uniques, en minuscules, qui correspondent exactement au href.
Les chemins relatifs rendent les liens portables entre le staging et la production. Utilisez about.html pour le même dossier, ../index.html pour le dossier parent et /blog/post.html pour les liens relatifs à la racine du site. Les URL absolues comme https://example.com/contact.html renvoient toujours vers cet hôte et sont moins portables. MDN présente des exemples de chemins relatifs à l’origine et au répertoire
Un bon texte d’ancre est descriptif, raisonnablement concis et pertinent par rapport à la page où il se trouve et à celle vers laquelle il pointe. Un texte générique comme Click here ou Read more ne donne aux utilisateurs ni aux robots d’exploration aucun contexte sur la destination. Remplacez-le par une formulation qui décrit la cible, par exemple cheese types au lieu de click here. Bonnes pratiques pour les liens
Non. L’attribut rel définit la relation entre une ressource liée et le document actuel, et nofollow indique que l’auteur ne cautionne pas le document référencé. Google conseille d’utiliser nofollow uniquement lorsque vous ne faites pas confiance à la source, ce qui s’applique aux liens externes non fiables ou générés par les utilisateurs, et non à votre propre navigation.
Assurez-vous que chaque page importante pour vous reçoit un lien depuis au moins une autre page de votre site, à l’aide d’un élément standard <a href>. Les pages accessibles uniquement via un sitemap ou un routeur côté client risquent d’être difficiles à découvrir, pour les robots d’exploration comme pour les utilisateurs. Ajouter un lien contextuel depuis une page hub pertinente règle ce problème de découvrabilité. Recommandations sur la couverture
Non, la correspondance est sensible à la casse. href="#Pricing" ne fera pas défiler la page de manière fiable jusqu’à id="pricing", car les caractères diffèrent par leur casse. Écrivez vos valeurs id en minuscules et assurez-vous que href="#value" correspond exactement à id="value", casse comprise.
Articles connexes
HarperFlow publie des articles hautement structurés intégrant des FAQ, des tableaux de données et des blocs de réponses directes qui répondent aux normes de citation rigoureuses exigées par les moteurs de recherche basés sur l'IA. En auditant et en améliorant continuellement votre contenu grâce à l'analyse des réponses IA, HarperFlow aide votre site à bâtir une autorité et une visibilité durables qui survivent aux stratégies dépendantes de la publicité.
Commencez votre essai dès aujourd'huiPassionné par l'automatisation et la création de contenu.
Votre confidentialité
Le stockage nécessaire garde le site sûr et fonctionnel. Avec votre permission, l’analytique nous aide à l’améliorer et les outils marketing mesurent nos campagnes. Google peut encore recevoir des signaux limités sans cookies lorsque le stockage optionnel est désactivé. Consultez notre Politique de confidentialité.
Votre navigateur envoie un signal de confidentialité (Global Privacy Control) : les technologies optionnelles sont donc désactivées par défaut — votre choix ici prévaut.
Choix de confidentialité
Le stockage nécessaire assure la sécurité, le consentement et les fonctionnalités que vous demandez. Les catégories optionnelles peuvent être modifiées à tout moment.
Sécurité, prévention de la fraude, préférences de consentement, envoi des formulaires et suppression des popups.
Votre navigateur envoie un signal Global Privacy Control : les technologies optionnelles sont désactivées par défaut. Votre choix explicite ici prévaut.
Un manuel AEO/GEO pratique pour rendre votre site Webflow plus clair, mieux sourcé et plus facile à utiliser pour les moteurs de réponse — sans gadgets ni fausses promesses.
Repérez les lacunes de découverte, d’extraction, de preuves, d’autorité et de fraîcheur
Utilisez les modèles de preuves, les briefs et les fiches à remplir
Menez un sprint opérationnel AEO/GEO ciblé de 30 jours
Nous venons de vous l’envoyer par e-mail. Il devrait arriver d’ici quelques minutes.
S’il n’apparaît pas dans votre boîte de réception d’ici quelques minutes, vérifiez vos spams ou l’onglet Promotions.