Automatiser les tests d’un système de gestion de contenu, c’est remplacer les clics manuels par des tests scriptés pour valider à la fois les workflows de rédaction du back-office (authentification et RBAC, CRUD de contenu, gestion des médias et états du workflow de publication) et le rendu front-end ou la sortie API qui en résultent. Les vérifications manuelles ponctuelles, qui ne passent pas à l’échelle dès que les rôles, les types de contenu et les environnements se multiplient, cèdent la place à des scripts qui vérifient précisément les parcours sur lesquels les éditeurs s’appuient au quotidien. Bien menée, cette automatisation détecte les défaillances les plus critiques avant qu’elles n’atteignent la production : éditeurs bloqués après un changement de rôle, brouillons qui ne passent jamais à l’état publié ou médias dont l’upload échoue.
Ce guide couvre deux types d’architecture, car leurs surfaces de test diffèrent. Les CMS traditionnels ou monolithiques comme WordPress et Drupal regroupent la rédaction et le rendu dans une seule application : une simple mise à jour peut donc casser à la fois l’expérience d’édition et le site en ligne. Les CMS headless ou API-first comme Contentful, Strapi et Sanity séparent l’interface éditoriale de la diffusion : vous devez donc valider indépendamment l’application de rédaction, les API de contenu en REST ou GraphQL et chaque front-end qui les consomme.
Dans les deux modèles, l’automatisation se décompose en trois couches concrètes que la suite de ce guide passe en revue : les workflows d’administration et de back-office, où le contenu est créé, relu et encadré ; le rendu front-end, où l’on vérifie les templates, les styles et le comportement responsive ; et la validation des API et du headless, où les schémas, les réponses de diffusion et les webhooks font l’objet de tests de contrat. La première couche à automatiser est la partie administration, celle que les éditeurs manipulent réellement.
Tester le back-office et les workflows d’administration revient à valider l’expérience d’édition elle-même : authentification, limites des permissions RBAC, CRUD de contenu, gestion de la médiathèque et workflows de publication à états. Ces tests échouent le plus souvent quand les sélecteurs reposent sur des détails fragiles du DOM ; c’est pourquoi Cypress, dans ses bonnes pratiques officielles, recommande d’utiliser des attributs data-* pour isoler les tests des modifications CSS ou JS.
Les interfaces d’administration des CMS, traditionnels comme headless, posent trois problèmes récurrents : les ID dynamiques et les noms de classes générés automatiquement, les éditeurs WYSIWYG/texte enrichi affichés dans des iframes, et les sauvegardes automatiques asynchrones. La solution passe par des sélecteurs fondés sur un contrat : ajoutez des attributs data-testid ou data-cy stables au niveau des composants de rédaction et ciblez-les plutôt que des chaînes de balises, de classes ou de XPath. Playwright formalise cette approche avec des locators qui gèrent l’attente automatique et l’entrée dans les iframes via frameLocator et getByTestId pour data-testid, tandis que Cypress impose la même stratégie fondée sur les attributs data, avec une relance intégrée sur les indicateurs de sauvegarde.
| Étape / Champ | Ce qu’il faut saisir | Exemple de valeur |
|---|---|---|
| Rôle testé | Rôle RBAC soumis au test | éditeur — pas d’accès aux paramètres Utilisateurs |
| Type de contenu | Modèle de contenu du CMS | Article de blog |
| Payload de création | Titre, corps, métadonnées | Titre : « Changelog nov. 2026 », Corps : 320 mots, Titre SEO : 58 caractères |
| Action sur les médias | Import et étiquetage | hero-1200x628.jpg, Alt : « Équipe déployant une mise à jour du CMS », Étiquette : release |
| Transition d’état | Transition du workflow à valider | Brouillon → Relecture → Planifié pour le 2026-11-15T09:00:00Z |
| Assertion | Vérification des permissions ou de la persistance | L’éditeur voit le bouton Publier désactivé ; l’auteur obtient un code 200 sur l’URL de prévisualisation |
N’exécutez jamais de suites de tests automatisés destructifs sur une instance de CMS en production : isolez-les toujours dans un environnement de staging ou des environnements éphémères alimentés en données de test.
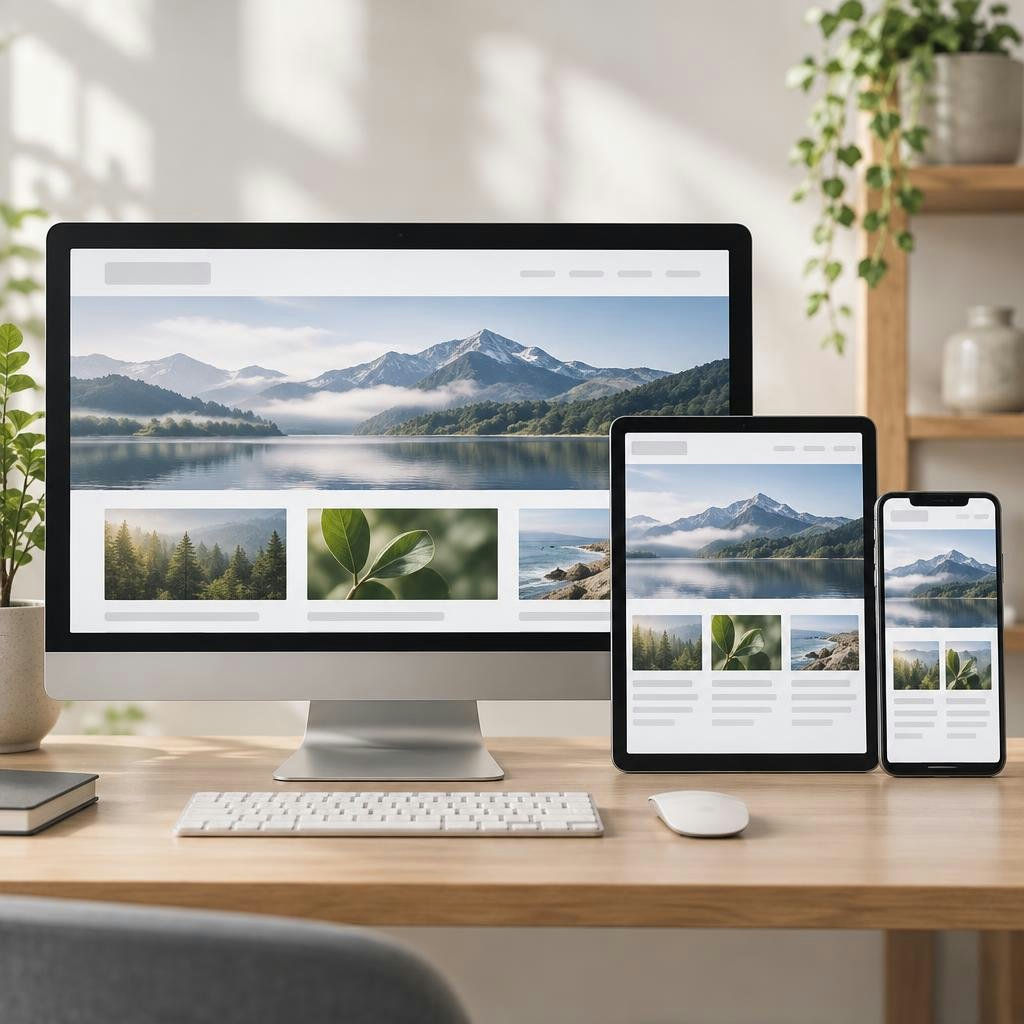
Le rendu front-end, la régression visuelle et la validation responsive garantissent que le contenu du CMS s’affiche réellement comme prévu dans le navigateur : des captures d’écran de référence automatisées détectent les ruptures CSS, des assertions sur le balisage confirment la correspondance entre champs et HTML, et des tests de viewport vérifient les mises en page sur mobile, tablette et desktop. Un rendu correct suppose que les données qui parviennent au front-end soient elles-mêmes correctes. Dans une architecture headless, cela implique de tester directement la couche API avant de se fier aux résultats de la suite de tests front-end.
Un CSS instable, les décalages liés au chargement des polices et les désalignements de grille font rarement échouer une assertion fonctionnelle. La comparaison avec des captures d’écran de référence, si. D’après la documentation de Playwright sur la comparaison visuelle, l’outil génère des images de référence lors de la première exécution via await expect(page).toHaveScreenshot() et fait échouer les exécutions suivantes dès que les pixels divergent. Il stocke les références au format PNG/WebP à côté du fichier de spec et s’appuie sur la bibliothèque pixelmatch, avec des paramètres threshold et maxDiffPixels configurables pour tolérer l’anticrénelage. En pratique, Applitools gère les références dans le cloud et effectue le rendu sur sa Visual Grid pour une couverture multinavigateur, Percy capture des instantanés du DOM et les restitue dans sa propre ferme de navigateurs, tandis que Playwright conserve les références en local, sous contrôle de version, pour des vérifications rapides et autonomes. Optez pour une gestion dans le cloud pour les grandes matrices multinavigateurs ; choisissez Playwright pour un déterminisme peu coûteux, local au dépôt.
Les champs du CMS doivent correspondre au rendu final. Automatisez les vérifications garantissant que title, h1, le corps du texte, les URL canoniques, meta[name="description"], les balises og: et les blocs JSON-LD application/ld+json reflètent l’entrée tout juste publiée. Analysez le DOM et vérifiez les chaînes exactes, pas seulement l’existence des sélecteurs.
Validez les mêmes templates à 375px, 768px et 1440px de largeur. Playwright prend en charge Chromium, WebKit et Firefox avec une émulation mobile native : vous pouvez donc exécuter les mêmes assertions visuelles sur tous les viewports en CI, sans parc d’appareils dédié. Faites échouer les tests en cas de débordement horizontal, de CTA masqués ou d’incohérences dans le repli de la navigation.
Exécutez axe-core après le rendu de chaque template et vérifiez qu’il n’y a aucune violation d’impact critique. Rattachez les échecs aux critères de succès du W3C WCAG 2.2, comme 1.4.3 Contraste (minimum), 2.4.7 Visibilité du focus et 4.1.2 Nom, rôle et valeur, qui définissent des exigences testables plutôt que des checklists secondaires. Analysez les pages de liste, les pages de détail et les états d’erreur, pas seulement la page d’accueil.
Une fois le rendu vérifié, la surface de risque restante se situe au niveau de la couche API et infrastructure qui relie le contenu à sa diffusion.
La validation des API et des CMS headless pour Contentful, Strapi, Sanity et Payload consiste à tester le contrat d’API lui-même, et non les pages. Vous vérifiez que les endpoints REST et GraphQL renvoient le statut, la structure de payload et les résultats filtrés attendus après chaque événement éditorial, au lieu de supposer que le front-end masquera le problème. Le revers de la médaille : le découplage rend les défaillances invisibles dans l’interface du CMS. Un éditeur peut publier sans la moindre erreur pendant que les consommateurs de l’API de diffusion reçoivent un changement de schéma cassant ou une réponse non autorisée.
Pour tester les endpoints, vérifiez des contrats explicites. Contrôlez 200 vs 404 vs 401 pour l’accès public vs la prévisualisation, confirmez la structure du tableau data/items, les types de champs et leur nullabilité, et validez les filtres de requête comme fields.slug dans Contentful ou filters[title][$eq] dans Strapi. Les variantes GraphQL exigent la même rigueur : ensembles de sélection corrects, extensions d’erreur et curseurs de pagination. Strapi indique que tous les types de contenu sont privés par défaut et nécessitent des permissions publiques explicites ou des requêtes authentifiées, ce qui fait des tests d’authentification négatifs un cas à part entière.
La validation du schéma et du modèle de contenu détecte les changements de contenu cassants. Écrivez des assertions garantissant que les champs obligatoires existent pour chaque entrée d’un type, que les références se résolvent et qu’aucun nouveau type de contenu n’apparaît sans versionnage. Lorsqu’un champ est renommé de excerpt en summary, ce sont les tests de diffusion qui doivent échouer immédiatement, pas la production.
Les webhooks et l’invalidation du cache complètent la boucle. Contentful décrit les webhooks comme des callbacks HTTP qui notifient les systèmes externes lorsque les données changent. Sa politique de relance par défaut tente la livraison puis, en cas de 429 ou de 5xx, réessaie jusqu’à 2 fois supplémentaires avec un délai d’environ 30 secondes, soit 3 tentatives au total en une minute, avec un timeout de 30 secondes. Automatisez ce scénario en publiant une entrée, en capturant le webhook avec un récepteur de test et en interrogeant l’API de diffusion jusqu’à ce que la nouvelle version apparaisse. Si vous servez le contenu via un CDN, vérifiez que les en-têtes de purge ou les surrogate keys sont bien déclenchés et que les réponses obsolètes disparaissent dans la fenêtre définie par votre SLO.
Pour l’authentification, testez explicitement les tokens à portée limitée. Vérifiez que les clés de diffusion en lecture seule ne peuvent pas écrire, que les clés de prévisualisation renvoient les entrées en brouillon et que les clés API expirées ou à portée trop restreinte reçoivent un 401/403. Effectuez une rotation de clé en environnement de test et confirmez que la diffusion échoue jusqu’à la mise à jour.
Postman et REST Assured sont ici les outils de référence. Dans Postman, vous écrivez des vérifications post-réponse avec la syntaxe Chai.js en utilisant pm.test et pm.response pour contrôler le statut, les chemins JSON et le temps de réponse, puis vous exécutez les collections avec Newman en CI. REST Assured offre la même chose pour les stacks JVM, avec des chaînes given/when/then pour la validation de schéma JSON.
Playwright a introduit la prise en charge native de Chromium, WebKit et Firefox dans une API unique, tandis que Cypress a conservé son architecture intégrée au navigateur pour les snapshots time-travel et l’attente automatique. Le choix entre ces cinq outils se résume à leur mission respective : Playwright ou Cypress pour l’automatisation de l’interface d’administration, Postman/Newman pour les contrats d’API headless, Applitools/Percy pour la régression visuelle et axe-core pour l’accessibilité. Les enquêtes de satisfaction menées auprès des développeurs ont classé Playwright et Cypress parmi les frameworks de test les mieux accueillis ces dernières années, même si les classements exacts varient selon l’année de l’enquête et doivent être vérifiés par rapport à l’édition en cours avant d’être cités comme actuels.
Choisir les outils n’est que la première étape : la suite reste utile au fil de l’évolution du CMS et du modèle de contenu si elle s’organise selon la valeur ajoutée de chaque outil plutôt que selon l’étiquette qu’il porte.
Playwright vous offre la prise en charge de Chromium, WebKit et Firefox dès l’installation, une parallélisation intégrée et la gestion des parcours multi-onglets et cross-origin. Il convient donc particulièrement aux architectures de CMS headless où les domaines éditorial, de prévisualisation et de diffusion divergent, ainsi qu’aux équipes plus importantes qui exécutent une matrice multinavigateur en CI. Cypress prend en charge Firefox et les navigateurs de la famille Chrome, le débogage time-travel, l’attente automatique et des tests de composants matures. Il convient aux équipes axées JS et TS qui valident des parcours d’administration WordPress, Drupal ou AEM, où le débogage interactif compte davantage que la couverture WebKit.
Postman et Newman constituent le point de contrôle des contrats pour les API headless. Versionnez vos collections et exécutez la CLI Newman en CI pour vérifier l’authentification, le filtrage, la pagination et les signatures de webhook que les tests d’interface ne couvrent pas. Applitools et Percy assurent la comparaison de captures d’écran et de mises en page selon les breakpoints. Ils détectent les régressions CSS qui échappent aux vérifications fonctionnelles, mais ne vérifient pas la logique de publication. axe-core injecte des contrôles de règles d’accessibilité directement dans les exécutions Playwright ou Cypress ; il s’agit d’une bibliothèque embarquée, pas d’un runner distinct.
Les vérifications de PR doivent rester rapides : des assertions axe-core dans deux specs Playwright ou Cypress critiques, plus des tests de contrat Postman et Newman pour les appels de création de brouillon, de mise à jour et de publication. Le pré-déploiement sur une instance CMS de staging est l’étape où vous investissez dans l’étendue de la couverture : tests E2E Playwright ou Cypress complets couvrant la connexion, le RBAC et la publication, comparaison complète des baselines visuelles via Applitools ou Percy, et CRUD destructif sur un espace ou une sandbox isolés. Le smoke test de production post-déploiement doit être en lecture seule : sondes de santé Playwright pour les routes front-end clés, moniteurs Postman en GET uniquement pour la disponibilité de l’API et un seul passage axe-core, sans création ni suppression de contenu.
| Outil | Couche de test principale | Cas d’usage idéal (type de CMS/taille d’équipe) | Étape CI/CD | Principale limite |
|---|---|---|---|---|
| Playwright | Interface d’administration en E2E, front-end multinavigateur | Headless + traditionnel ; équipes moyennes/grandes ayant besoin de WebKit | PR : composants + mocks d’API ; pré-déploiement : E2E complet ; post-déploiement : smoke test en lecture seule | Configuration plus lourde pour les équipes 100 % JS ; IA visuelle en option |
| Cypress | Interface d’administration en E2E, tests de composants | Équipes axées JS/TS ; petites/moyennes équipes sur WordPress/Drupal/AEM | PR : spec rapide ; pré-déploiement : suite complète ; post-déploiement : smoke test en lecture seule | Un seul onglet/contexte ; WebKit limité ; parallélisation payante |
| Postman/Newman | Contrat d’API, validation des webhooks | Tout CMS headless (Contentful, Strapi, Sanity), toutes tailles d’équipe | PR : schéma + authentification ; pré-déploiement : CRUD + webhook ; post-déploiement : contrôle de santé en GET uniquement | Aucune couverture de l’interface navigateur ni visuelle ; maintenance des collections |
| Applitools/Percy | Régression visuelle, diffs responsive | Design systems et sites marketing | PR : snapshots limités ; pré-déploiement : comparaison complète des baselines ; post-déploiement : rattrapage optionnel | Bruit des baselines ; service payant ; aucune assertion fonctionnelle |
| axe-core | Analyse d’accessibilité dans les tests E2E | Tous types de CMS nécessitant des contrôles WCAG | PR : injection rapide ; pré-déploiement : analyse complète des pages ; post-déploiement : surveillance des régressions | Règles automatisées uniquement ; audit manuel nécessaire |
Une checklist d’automatisation des tests CMS passe à l’échelle lorsque les workflows de publication côté administration, les contrats de schéma d’API et les vérifications de rendu front-end réussissent tous sur des données isolées injectées via l’API, et restent au vert pendant deux cycles de release consécutifs. Utilisez cette checklist d’exécution pour auditer votre propre suite : chaque élément doit avoir un responsable, un signal clair de réussite/échec et une date de dernière revue.
Commencez là où le risque et la fréquence des changements sont les plus élevés. Si le temps vous manque, automatisez d'abord les parcours de publication et de permissions par rôle, ainsi que la validation du schéma d'API, car leurs défaillances pénalisent le chiffre d'affaires et le rythme éditorial. Ajoutez la régression visuelle une fois que les vérifications de publication et d'API sont restées stables sur trois versions, puis ajoutez un scan d'accessibilité automatisé sur les templates une fois les références visuelles verrouillées.
Commencez l'automatisation là où les éditeurs manipulent le plus souvent le contenu et là où les pannes coûtent le plus cher : workflows de publication et intégrité du schéma d'API, avant d'investir dans une régression visuelle au pixel près
Livrez la checklist sous forme de code. Les équipes qui maintiennent un CMS fiable traitent la génération des données de test, l'isolation des environnements et l'élimination des tests instables comme du travail produit, et non comme des corvées de test.
HarperFlow publie des articles hautement structurés, avec FAQ, tableaux de données et blocs de réponse directe, qui satisfont aux exigences de citation rigoureuses des moteurs de recherche IA. En auditant et en améliorant votre contenu en continu grâce à l'analyse des réponses IA, HarperFlow aide votre site à bâtir une autorité et une visibilité durables, qui survivent aux stratégies dépendantes de la publicité.
Utilisez des attributs contractuels comme data-testid ou data-cy sur les composants d'édition et ciblez-les plutôt que les classes. Playwright le permet avec page.getByTestId() et des locators à attente automatique, tandis que Cypress recommande d'utiliser des attributs data-*, conformément à ses bonnes pratiques.
Créez d'abord un frame locator, puis localisez l'élément éditable à l'intérieur avec frameLocator. La documentation de Playwright indique qu'il faut créer un frame locator qui entre dans l'iframe et permet d'y sélectionner des éléments, ce qui résout les problèmes de timing et de focus sans chaînes XPath fragiles.
Conservez les références dans le contrôle de version au format PNG ou WebP et ajustez la tolérance de différence plutôt que de mettre à jour les références à l'aveugle. Playwright utilise la bibliothèque pixelmatch et expose threshold (valeur par défaut : 0.2) et maxDiffPixels via await expect(page).toHaveScreenshot().
Non. Isolez toujours les suites destructives sur le staging ou sur des espaces éphémères alimentés par des données de seed. Les smoke tests en production doivent se limiter à des vérifications en lecture seule, comme des moniteurs d'API en GET uniquement et des sondes de santé front-end.
Publiez une entrée, capturez le callback avec un récepteur de test, puis vérifiez la livraison et la purge du cache. Contentful définit les webhooks comme des callbacks HTTP avec un délai d'expiration de 30 secondes ; en cas de 429 ou de 5xx, il réessaie 2 fois de plus après un délai d'environ 30 secondes, soit 3 tentatives au total sur une fenêtre de 1 minute.
Testez à la fois les cas d'authentification positifs et négatifs. Comme tous les types de contenu sont privés par défaut et doivent soit être rendus publics, soit être interrogés via des requêtes authentifiées, vérifiez que les clés de diffusion en lecture seule reçoivent une erreur 401 ou 403, que les clés expirées échouent et que les clés de prévisualisation renvoient bien les brouillons.
Rédigez des vérifications post-réponse dans l'onglet « Tests » à l'aide de la bibliothèque intégrée. Postman embarque Chai.js en natif et vous définissez vos tests avec pm.test pour vérifier le statut, les chemins JSON et le temps de réponse, puis vous exécutez les collections avec Newman en CI.
Choisissez Playwright lorsque vous avez besoin de Chromium, WebKit et Firefox en une seule exécution, d’une émulation mobile native et de parcours multi-onglets ou cross-origin, fréquents dans les architectures headless. Cypress convient bien aux équipes très orientées JS qui apprécient le débogage « time-travel » et pour qui la couverture de Firefox et des navigateurs de la famille Chrome est suffisante.