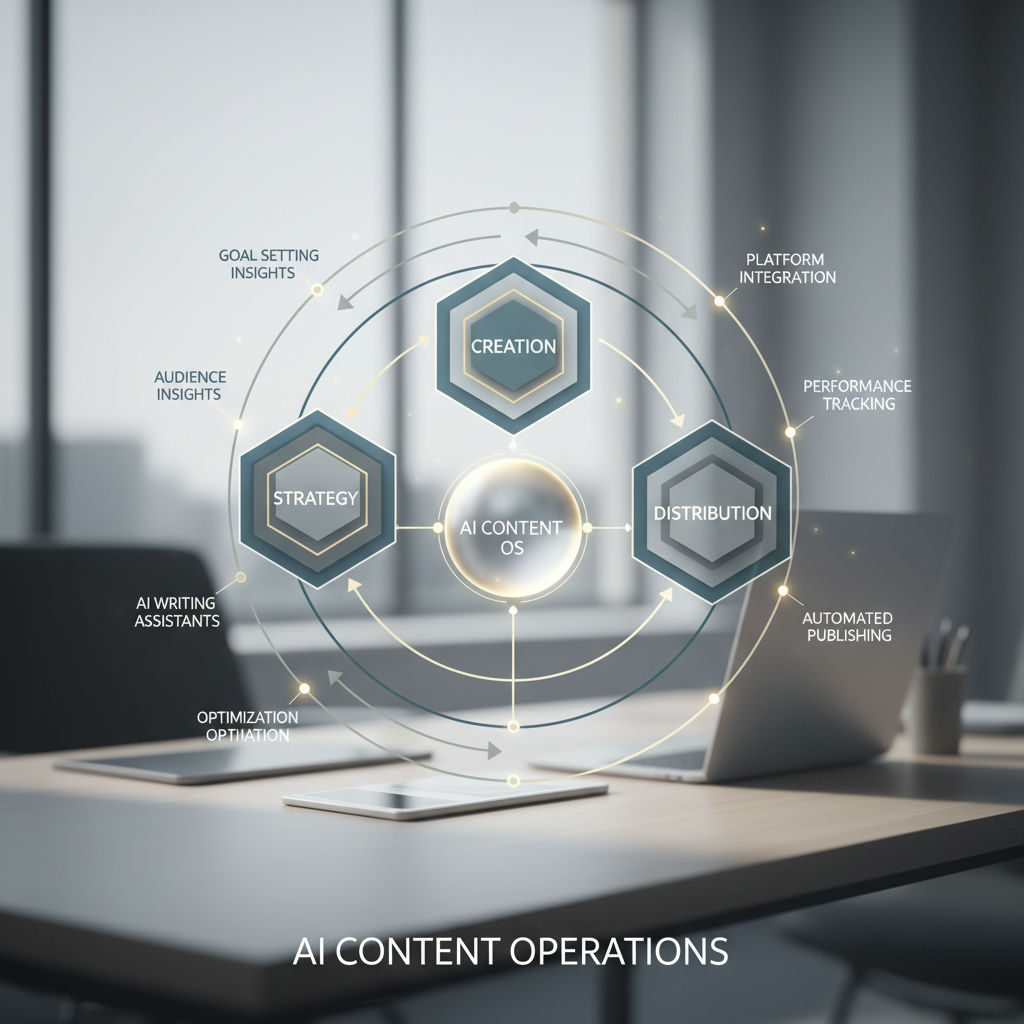
Les opérations de contenu IA désignent l'intégration systématique de l'IA dans la recherche, la rédaction, la relecture, la publication et la diffusion, encadrée par des workflows documentés, des responsabilités clairement attribuées et des points de contrôle qualité réellement appliqués : pas le simple recours à un rédacteur IA pour produire du texte. La création de contenu assistée par IA, c'est une personne qui sollicite un modèle pour une tâche ponctuelle ; les opérations de contenu IA, c'est un système reproductible et gouverné qui transforme ces tâches en contenus validés, publiés et maintenus dans le temps. WP Engine résume l'idée sous-jacente par l'application de l'intelligence artificielle à l'ensemble du cycle de vie du contenu, mais cette formulation décrit la surface, pas le mécanisme.
La différence se voit dans la façon dont le travail circule. Dans la création assistée par IA, un rédacteur demande un plan ou un brouillon à un modèle, le retravaille et le met en ligne, les décisions restant enfouies dans des prompts personnels et des historiques de conversation. Dans les opérations de contenu IA, l'équipe définit comment les sujets entrent dans le pipeline, ce que doit contenir un brief, qui valide quoi, où les contenus sont centralisés comme source unique de vérité, et quels contrôles doivent être passés avant publication. Cette couche associe l'IA aux workflows, aux technologies et à la gouvernance déjà en place pour soutenir la planification, la création, la relecture, la publication, l'analyse et l'optimisation, tout en maintenant une supervision humaine. Le principe de fonctionnement est explicite : les humains portent la stratégie et valident les livrables, l'IA absorbe le volume sur la recherche, la rédaction, le balisage et la veille. Sans cette couche, l'IA produit du volume qui génère de la dette de relecture au lieu d'augmenter la cadence de production.
La plupart des articles de vulgarisation publiés aujourd'hui ne retiennent que l'enchaînement des phases : réception et analyse, création, gestion, diffusion, réutilisation et mesure, ou une variante listant planification, recherche et briefing, rédaction et production, gouvernance et contrôle qualité, puis analyse. Ces phases décrivent ce qui se passe, pas comment vous savez que le résultat est à la hauteur.
C'est dans cet écart que les opérations prennent tout leur sens. Les opérations de contenu, c'est le système qui coordonne les personnes, les processus et les outils pour qu'une équipe puisse planifier, produire, encadrer et mesurer ses contenus à grande échelle : ce que l'on obtient lorsqu'on pilote la production comme un système maîtrisé plutôt que comme une succession d'exploits individuels. Pour les opérations de contenu IA, la précision supplémentaire tient à une qualité mesurable : chaque contenu répond-il, avant sa mise en ligne, à des standards explicites de vérification des sources, d'exactitude factuelle, de clarté structurelle et de voix de marque, plutôt que de s'en remettre à une relecture vague a posteriori sur l'exactitude et la cohérence de marque ?
Cette définition n'a d'intérêt que si le workflow qui la sous-tend comporte de vrais points de contrôle, et pas seulement des étapes.
Comment savoir qu'un article assisté par IA est réellement prêt à être publié ? Les opérations de contenu IA y répondent par six étapes verrouillées, chacune assortie d'un contrôle mesurable réussite/échec plutôt que d'un vague « ça me paraît bien ». Une fois les étapes définies, le véritable facteur différenciant est la part de ce pipeline qu'une équipe pilote elle-même, par opposition à ce qu'elle délègue.
Un pipeline qui fonctionne traite la relecture comme une inspection, pas comme une opinion. Adobe, dans son analyse de la revue et de la validation unifiées, constate que les créatifs passent l'essentiel de leur temps sur des tâches comme la gestion des fichiers, le suivi des retours et les relances, plutôt que sur un travail à réelle valeur ajoutée : c'est précisément pourquoi les points de contrôle doivent être explicites et auditables.
Point de contrôle : dispose-t-on de preuves datées d'une demande et d'un manque à combler ? Pour valider, il faut un volume de recherche ou un cluster de questions, une liste des sources actuellement les plus citées avec leurs dates de publication, et un angle formulé en une phrase qui apporte quelque chose d'absent de ces sources. Pas de preuves, pas de rédaction.
Point de contrôle : l'argument central est-il énoncé dans les 100 premiers mots ? Pour valider, il faut un bloc de réponse directe, un périmètre d'affirmation défini et aucune donnée chiffrée non sourcée dans l'introduction. Si le brouillon ne parvient pas à énoncer clairement sa réponse, il repart en correction.
Point de contrôle : l'article respecte-t-il la structure minimale pour être parcouru et cité ? Pour valider, il faut des H3 logiques, des paragraphes courts, au moins une donnée chiffrée ou un bloc de définition par section principale, et des références de sources explicites rattachées aux affirmations. Les équipes qui visent la citation par les outils d'IA formalisent souvent cela plus loin, avec des règles définies de structure et de sourcing. Les plateformes plus lourdes présentent ce même travail comme la gestion des campagnes, des contenus et des relectures telle que votre équipe travaille réellement, avec validations, gestion des versions et localisation intégrées pour protéger la qualité.
Point de contrôle : chaque affirmation structurante est-elle traçable ? Une vérification rigoureuse suppose d'ouvrir chaque source citée, de confirmer la date de publication et l'autorité de l'auteur, et de faire correspondre exactement le chiffre ou la définition. Les sources acceptables sont les documents primaires de niveau T1, les données officielles ou les travaux évalués par les pairs. Le blog d'un éditeur peut apporter du contexte, mais ne peut pas être l'unique source d'une statistique. Si une traçabilité échoue, l'affirmation est supprimée ou remplacée.
Point de contrôle : la conformité se vérifie face à une charte rédactionnelle écrite, pas à l'intuition. Pour valider, il faut un passage au crible des formulations interdites, une correspondance avec la liste terminologique, aucune tournure à la première personne contraire aux règles de marque, et des critères de ton notés de 1 à 3 par un relecteur humain. Le relecteur doit consigner ses modifications, pas seulement valider.
Point de contrôle : le contenu final est-il auditable ? Pour valider, il faut un slug d'URL définitif, un meta title et une meta description dans les limites de caractères, une balise canonique, des textes alternatifs d'images, et toutes les citations affichées sous forme de liens actifs pointant vers les bons domaines. Une seconde paire d'yeux confirme qu'il ne reste aucune URL de page de résultats de moteur de recherche ni aucun lien non déclaré.
Une relecture sans critères de réussite ou d'échec définis sur le sourcing et la structure n'est pas un contrôle qualité : c'est un tampon de complaisance.
Considérer la rédaction entièrement manuelle, la rédaction assistée par IA et les moteurs de contenu entièrement automatisés comme un même métier mené avec des outils différents est l'erreur la plus coûteuse en opérations de contenu IA. Ce sont trois modèles opérationnels distincts, aux arbitrages opposés en matière de contrôle, de rapidité, de coût, de cohérence et d'aptitude à être cité. Les éditeurs de solutions écrasent ces nuances, mais dans les faits la plupart des équipes se situent quelque part sur un véritable spectre, et ce qu'un modèle doit produire dépend de la façon dont les contenus sont trouvés aujourd'hui.
Le tout-manuel signifie qu'une personne réalise chaque étape : brief, recherche, plan, rédaction, édition, mise en forme, publication. Le contrôle est maximal et le point de vue authentique, mais le volume produit dépend directement des heures humaines. Les publications prennent du retard dès que le calendrier se charge, et le style varie d'un rédacteur à l'autre.
Pour les équipes qui veulent de la vitesse sans renoncer au jugement, le manuel assisté par l'IA laisse les humains maîtres du workflow tout en branchant l'IA tâche par tâche. Un rédacteur peut utiliser un modèle pour les premiers jets, des variantes de titres ou la déclinaison d'un contenu en posts sociaux, puis éditer, vérifier les faits et publier manuellement. C'est plus rapide que le manuel et le jugement éditorial reste entier, mais les gains dépendent de la discipline. Comme le résume une analyse d'opérateur, la création de contenu automatisée est un spectre, pas un interrupteur, et c'est au milieu que la plupart des équipes opèrent réellement.
La limite des moteurs de contenu entièrement automatisés, c'est qu'ils ne fonctionnent que si les contrôles qualité, la traçabilité des citations et les règles de mise en forme sont intégrés au pipeline. Ces moteurs relient les étapes de bout en bout : recherche de mots-clés ou de sujets, rédaction avec sources, mise en forme structurelle et publication directe dans le CMS, avec un point de contrôle humain avant toute mise en ligne. HarperFlow est un exemple concret de ce niveau pour les équipes Webflow : il automatise la recherche, la rédaction, la mise en forme et la publication vers Webflow tout en conservant la relecture et le droit de veto humains plutôt que de publier automatiquement sans validation.
| Critère | Manuel | Manuel assisté par l'IA | Entièrement automatisé |
|---|---|---|---|
| Niveau de contrôle | Contrôle humain total, chaque affirmation vérifiée par un éditeur | Moyen : l'IA rédige, mais l'humain garde la main sur le workflow et l'édition finale | Contrôle sous condition : l'automatisation exécute le pipeline, avec droit de veto humain avant publication |
| Vitesse / volume de production | Lent, limité par les heures de rédaction et le calendrier | Premiers jets plus rapides, mais la déclinaison et la publication restent manuelles | Débit maximal, publication quotidienne sans recruter |
| Structure de coûts | Coût de main-d'œuvre élevé par article, coût des outils faible | Coût par article plus faible, auquel s'ajoutent les abonnements aux outils et le temps d'édition | Abonnement plus temps de relecture, passe à l'échelle sans croissance linéaire des effectifs |
| Risque de cohérence | Forte variabilité à l'échelle, dépend de chaque rédacteur | Moyen : le ton dérive sans règles de voix imposées | Faible si les règles et les audits sont intégrés, élevé en l'absence de points de contrôle qualité |
| Aptitude à être cité par les outils d'IA | Faible, sauf structuration délibérée avec sources et mise en forme | Variable, dépend de la discipline éditoriale en matière de sources et de structure | Maximale lorsque le pipeline impose par conception les citations, les dates et une mise en forme qui répond d'emblée |
L'arbitrage est clair. Le manuel vous donne du jugement et du contrôle, au prix de la vitesse et de l'échelle. Le manuel assisté par l'IA vous fait gagner des heures sur les étapes mécaniques, mais vous devez toujours gérer vous-même la recherche, la qualité et la régularité de la publication. L'entièrement automatisé vous achète l'échelle et la cohérence, à condition de faire confiance aux contrôles intégrés pour les sources, la structure et la voix de marque, et de conserver votre droit de veto.
L'automatisation n'est pas meilleure dans tous les cas. Si vous publiez quelques articles de fond à fort enjeu par mois, le manuel reste gagnant. Si vous avez besoin d'une production pédagogique régulière sans augmenter vos effectifs et que vous pouvez imposer des règles de sourcing, le niveau entièrement automatisé a du sens. La plupart des équipes en croissance testent d'abord le milieu, puis automatisent les parties qui se révèlent mécaniques.
Le choix du modèle opérationnel compte surtout là où le contenu est réellement découvert, et cela est en train de changer.
Structurer les opérations de contenu pour la découverte par l'IA, c'est construire chaque page comme une série de blocs d'affirmations distincts et autonomes qu'un système de recherche par IA peut extraire, vérifier et citer sans le contexte environnant. Des tests récents sur la structure extractible des contenus font état de gains de taux de citation liés à ce type de mise en forme, indépendamment des signaux de classement traditionnels, même si l'ampleur de cet effet varie selon les sources et les méthodologies.
HarperFlow publie des articles hautement structurés, avec des FAQ, des tableaux de données et des blocs de réponse directe qui respectent les exigences de citation strictes des moteurs de recherche IA. En auditant et en améliorant vos contenus en continu grâce à l'analyse des réponses IA, HarperFlow aide votre site à bâtir une autorité et une visibilité durables, qui survivent aux stratégies dépendantes de la publicité.
La découverte par l'IA change l'objectif : il ne s'agit plus de gagner une position, mais d'être extrait. Les opérations de search classiques optimisent pour les algorithmes de classement : placement des mots-clés, profil de backlinks et autorité de la page. Les opérations conçues pour les réponses IA optimisent pour l'analysabilité : un modèle peut-il découper la page, faire correspondre une requête à une seule section et remonter ce bloc avec son attribution intacte. De nombreux outils de réponse IA s'appuient sur plusieurs sources par réponse, en combinant plusieurs pages en une seule réponse : être extractible compte donc même lorsque vous n'êtes pas en première position.
La lecture humaine récompense le fil narratif et la montée en puissance de l'argumentation. La recherche par machine récompense les réponses explicites données tôt et une attribution cohérente. Les moteurs découpent le contenu selon la hiérarchie des titres, les sauts de paragraphe et les limites des éléments HTML, puis notent chaque bloc sur sa pertinence et sa vérifiabilité. Si la réponse n'apparaît qu'au douzième paragraphe, ou si l'attribution se trouve dans une bibliographie éloignée de l'affirmation, le moteur ne peut pas établir la provenance et passe son chemin.
1. La réponse d'abord. Ouvrez chaque grande section par une réponse complète et déclarative à la question implicite de son titre, formulée clairement dès le début plutôt qu'enfouie après une mise en contexte. Utilisez des H2 rédigés comme des questions, au plus près de la façon dont les gens interrogent réellement, pour que le moteur puisse identifier l'intention de recherche sans avoir à interpréter des libellés génériques comme « Points clés ».
2. La citation de sources primaires en ligne. Placez une source primaire nommée et liée juste à côté de l'affirmation qu'elle appuie : recherche académique, documentation officielle ou journalisme de première main. « Les chercheurs de [institution] ont constaté », avec un lien direct, vaut mieux que « des études montrent », car le modèle extrait l'affirmation et son attribution comme un tout et peut la vérifier.
3. Des éléments structurés pour des décisions structurées. Pour les comparatifs, les spécifications, les coûts, les calendriers et les séquences d'étapes, remplacez la prose continue par des tableaux, des listes de définitions, des cadres numérotés et des FAQ où chaque paire question-réponse tient seule. Ces éléments créent des cibles d'extraction distinctes qui ne demandent aucune restructuration. Les schémas standards comme Article, FAQPage et Organization, alignés sur le texte visible, lèvent l'ambiguïté, même si aucun balisage ne garantit l'inclusion dans une fonctionnalité de réponse IA donnée.
4. La fraîcheur et la discipline des dates. Signalez la récence de façon opérationnelle : ajoutez des mentions de dernière mise à jour, de courts historiques de modifications pour les sujets qui évoluent et des mises à jour immédiates dès qu'un fait change. Sur les requêtes sensibles au temps, les pages départagent les égalités grâce à la fraîcheur, car les moteurs préfèrent l'affirmation vérifiable la plus récente.
Pour les opérations de contenu, le changement est concret : faites passer le contrôle qualité des vérifications de densité de mots-clés à l'isolement des affirmations, à la traçabilité des sources et à la complétude structurelle, afin que chaque section puisse résister à une citation hors contexte.
Vos opérations de contenu IA fonctionnent lorsque votre équipe tient une cadence de publication régulière où chaque article passe la vérification des sources, obtient une présence mesurable dans les citations des réponses IA sous 60 jours et fait progresser la visibilité organique sans budget publicitaire supplémentaire. Tous les choix évoqués jusqu'ici, des étapes aux modèles jusqu'à la structure, se ramènent à une seule question : est-ce que cela fonctionne de manière mesurable ?
La plupart des équipes repèrent l'écart au même endroit. Le CMS affiche 20 articles ce mois-ci, mais seule la moitié figure au journal des points de contrôle, le nombre moyen de sources plafonne à deux liens par article, et personne ne sait dire si ces pages sont citées ailleurs. C'est de la production, pas un système opérationnel.
Mesurez quatre signaux ensemble. Premièrement, la cadence tenue au regard des points de contrôle franchis : combien d’articles planifiés ont été livrés et quel pourcentage a passé les contrôles de vérification, de voix de marque et de structure dès la première relecture. Deuxièmement, la densité de sources par article, c’est-à-dire le nombre de sources primaires distinctes citées et non le total des liens, en moyenne sur les 10 dernières publications. Troisièmement, la présence dans les citations des réponses IA au fil du temps, grâce à un suivi régulier des citations. Suivez la fréquence de citation par moteur, par ensemble de mots-clés et par date, ainsi que les parcours de référence liés à la marque dans vos outils d’analyse, car les clics seuls passent à côté de l’influence réelle dans un paysage de recherche où une part croissante des requêtes se termine sans le moindre clic. Quatrièmement, les tendances de visibilité organique indépendamment du payant : entrées non payantes, requêtes de marque et conversions assistées issues des renvois IA.
Le volume de contenu publié n’est pas en soi un indicateur de réussite ; un contenu cité, sourcé et structurellement solide, si.
Servez-vous des points de contrôle et des exigences structurelles décrits plus haut comme grille d’audit. Évaluez votre pipeline actuel sur chaque contrôle, repérez où les reprises s’accumulent, puis faites correspondre les écarts au palier de modèle opérationnel adapté à vos effectifs et à votre objectif de publication. Si vous passez à une rédaction assistée ou entièrement automatisée, conservez le même niveau d’exigence de vérification qu’en relecture manuelle (contrôle des sources, contrôle de la densité factuelle, contrôle de la structure), sinon le gain de cadence érodera le gain de confiance dont vous avez besoin pour être cité.
Le test concret est simple : si, au bout de 60 jours, vos articles passent les contrôles au rythme prévu, affichent une densité de sources supérieure et montrent une présence croissante dans les citations ainsi qu’une qualification organique en hausse sans soutien payant, l’opération fonctionne. Sinon, corrigez l’étape de vérification avant d’acheter davantage de capacité de production.
Gardez le manuel pour le leadership éclairé à fort enjeu, la recherche originale ou les contenus dont le point de vue est le produit lui-même. Utilisez les paliers automatisés pour le contenu pédagogique régulier, où les règles de sourcing et la structure peuvent être imposées et où un humain conserve un droit de veto avant publication. Cette répartition protège la qualité tout en gagnant en volume.
Mettez-le de côté dans un backlog en notant les preuves manquantes, plutôt que de le rédiger quand même. Ne le reprenez que lorsque vous pouvez y rattacher un cluster de questions ou une demande de recherche, ainsi qu’un angle distinct que les meilleures sources actuelles ne couvrent pas. Cela évite d’accumuler une dette de relecture liée à des brouillons spéculatifs.
Rédigez une charte de style écrite avec les expressions bannies, la terminologie validée et des exemples de ton notés de 1 à 3. Lancez d’abord un contrôle automatisé sur ces listes, puis demandez à un relecteur humain de consigner ses modifications au lieu de se contenter de valider. Ce journal devient une base d’apprentissage pour le cycle de rédaction suivant.
Oui, c’est le cas de la plupart des équipes. Attribuez le modèle en fonction du type de contenu et du risque, et non des préférences de l’équipe, et conservez le même niveau d’exigence de vérification pour les trois. Comme le soulignent les analyses présentant la création de contenu automatisée comme un spectre et non comme un interrupteur, c’est au milieu que se situent réellement la plupart des équipes en phase de montée en charge.
Supprimez ou remplacez immédiatement l’affirmation et consignez la raison de l’échec : date non concordante, autorité insuffisante ou absence de source primaire. Les remplacements acceptables sont des documents primaires, des données officielles ou des travaux évalués par les pairs, car les blogs d’éditeurs peuvent apporter du contexte mais ne peuvent pas porter à eux seuls une statistique. Le suivi des échecs montre où les prompts ou les listes de sources doivent être corrigés.
Traitez les mises à jour comme une étape soumise à validation, avec son propre point de contrôle : date de mise à jour, note de changelog et revérification de tous les chiffres modifiés. Vérifiez que les métadonnées, les textes alternatifs et les citations en ligne s’affichent toujours correctement et qu’aucun domaine mort ne s’est glissé dans l’article. L’actif reste ainsi traçable pour de futures citations.
Désignez un seul responsable humain, doté d’un droit de veto, qui vérifie le slug, la balise canonical et l’affichage des citations avant toute mise en ligne. HarperFlow documente un schéma similaire, où le système automatise la recherche, la rédaction, la mise en forme et la publication vers Webflow tout en conservant la relecture et le veto humains. Un relecteur clairement responsable évite les erreurs de publication automatique et préserve les pistes d’audit.
Adobe a constaté que les créatifs consacrent environ 70 % de leur temps à gérer des fichiers, suivre les retours et relancer, plutôt qu’à créer. Des points de contrôle explicites et des validations intégrées réduisent cette charge en rendant le succès ou l’échec visible au lieu de discutable. Mesurez le temps gagné dans le journal des points de contrôle, et pas seulement le nombre de contenus produits.